矢量量化(Vector Quantization, VQ)解决压缩的一个基本矛盾:数据取值无限,预算只容得下有限个代表。它把输入替换为码本中最近的码矢,之后只传索引,在固定比特率下追求平均失真最小——这也是 乘积量化(PQ):高维向量检索的工程基石 与 VQ-VAE 的共同地基。
问题与优化目标
矢量量化的方案很直接——准备一本含 个代表矢量的码本,任何输入都替换成离它最近的代表,之后存储与传输只需要代表的索引, 个比特。代价是失真:代表终究不是原值。 越大越逼真也越费比特——量化的一切设计与理论,都在这个矛盾里打转。
优化目标可以写成一句话:给定一批训练数据 、固定码本大小 (即固定比特率),找一本平均失真最小的码本。
决策变量其实是两件事: 个代表放在哪(码本),以及每个点归谁管(划分——数学上就是 Voronoi 划分)。好消息是两件事各自取到最优都不难;坏消息是同时最优是 NP-hard 的,实用解法只能交替逼近——这正是下一节 LBG 算法的路数。
这个问题有个完全同构的日常版本——连锁便利店选址。城市居民是数据点, 家店是码矢,每家店的服务区是胞腔;居民永远去最近的店(最近邻条件),老板把生意不佳的店搬到其服务区居民的质心处(质心条件),反复挪到平均到店距离不再下降为止(收敛到局部最优)。选址预算 ,就是比特率。
数学模型
符号表( 一族三用,靠参数与上下文区分):
| 符号 | 含义 |
|---|---|
| 矢量维度(每个矢量打包的标量个数) | |
| 输入空间, 维欧氏空间 | |
| 量化器, 的映射 | |
| 码本(codebook),有限码矢集合 | |
| 码矢(codevector) | |
| 码本大小 | |
| 比特率(bit per dimension, bpd) | |
| 胞腔(cell):归属码矢 的输入区域 | |
| 率失真函数:失真不超过 所需的最小码率(详见 率失真理论) | |
| 失真度量,默认 MSE | |
| 平均失真 | |
| 训练集 | |
| 无记忆高斯信源的方差 |
量化器 的规则只有一条——把输入替换为最近的码矢:
每个码矢统治一块胞腔(cell),全体胞腔构成 Voronoi 划分。
失真度量默认用 MSE, ;L1、余弦距离、加权 MSE 也常见。度量选择要对齐应用目标——检索场景若以余弦相似度为准,就用余弦度量训码本。
LBG 算法:交替最优
算法由 Linde、Buzo、Gray 于 1980 年提出,思想源头是 1957 年 Steinhaus 的最优划分问题。优化目标里的两个决策,分别取到最优,就是量化器的两个经典必要条件。最近邻条件:给定码本,每个矢量归入最近码矢的胞腔,
质心条件:给定划分,每个码矢取所在胞腔的质心(「把店搬到服务区质心」), 。对平均失真 关于 求导置零,MSE 下解出的正是质心——两个条件各自把问题化到最优,合起来就是坐标下降。
LBG 算法就是这两个条件的交替执行:初始化码本 → 最近邻划分 → 质心更新 → 失真下降小于阈值即停。 非负有下界且每步单调不增,必然收敛——但只到局部最优,结果依赖初始化。
初始化决定最终停在哪个局部最优,常见三种:随机采样、K-means++、分裂法(从 1 个码矢起步,每次分裂为二直至达到 ,最稳)。空胞腔是经典病:某码矢长期无样本归属就变死码,分裂法配合「空胞腔重置到最大失真样本」可缓解。
细看会发现 LBG 与 K-means 是同一个算法:码本大小 ↔ 聚类数,码矢 ↔ 聚类中心,Voronoi 划分 ↔ 聚类结果。码本设计问题等价于聚类问题,K-means 的全部研究(初始化、mini-batch、GPU 加速)可直接迁移。
import numpy as np

def lbg(X, n_codewords, n_iter=50, tol=1e-6, seed=0):
    """LBG 码本设计,结构上就是 K-means。"""
    rng = np.random.default_rng(seed)
    codebook = X[rng.choice(len(X), n_codewords, replace=False)].copy()
    prev = np.inf
    for _ in range(n_iter):
        # 划分:最近邻分配(K-means 的 E 步)
        d = ((X[:, None, :] - codebook[None, :, :]) ** 2).sum(-1)
        labels, dist = d.argmin(1), d.min(1).mean()
        if prev - dist < tol:      # 失真不再下降即收敛(局部最优)
            break
        prev = dist
        # 更新:胞腔质心(M 步;空胞腔保留原码矢)
        for i in range(n_codewords):
            pts = X[labels == i]
            if len(pts):
                codebook[i] = pts.mean(0)
    return codebook, labels, dist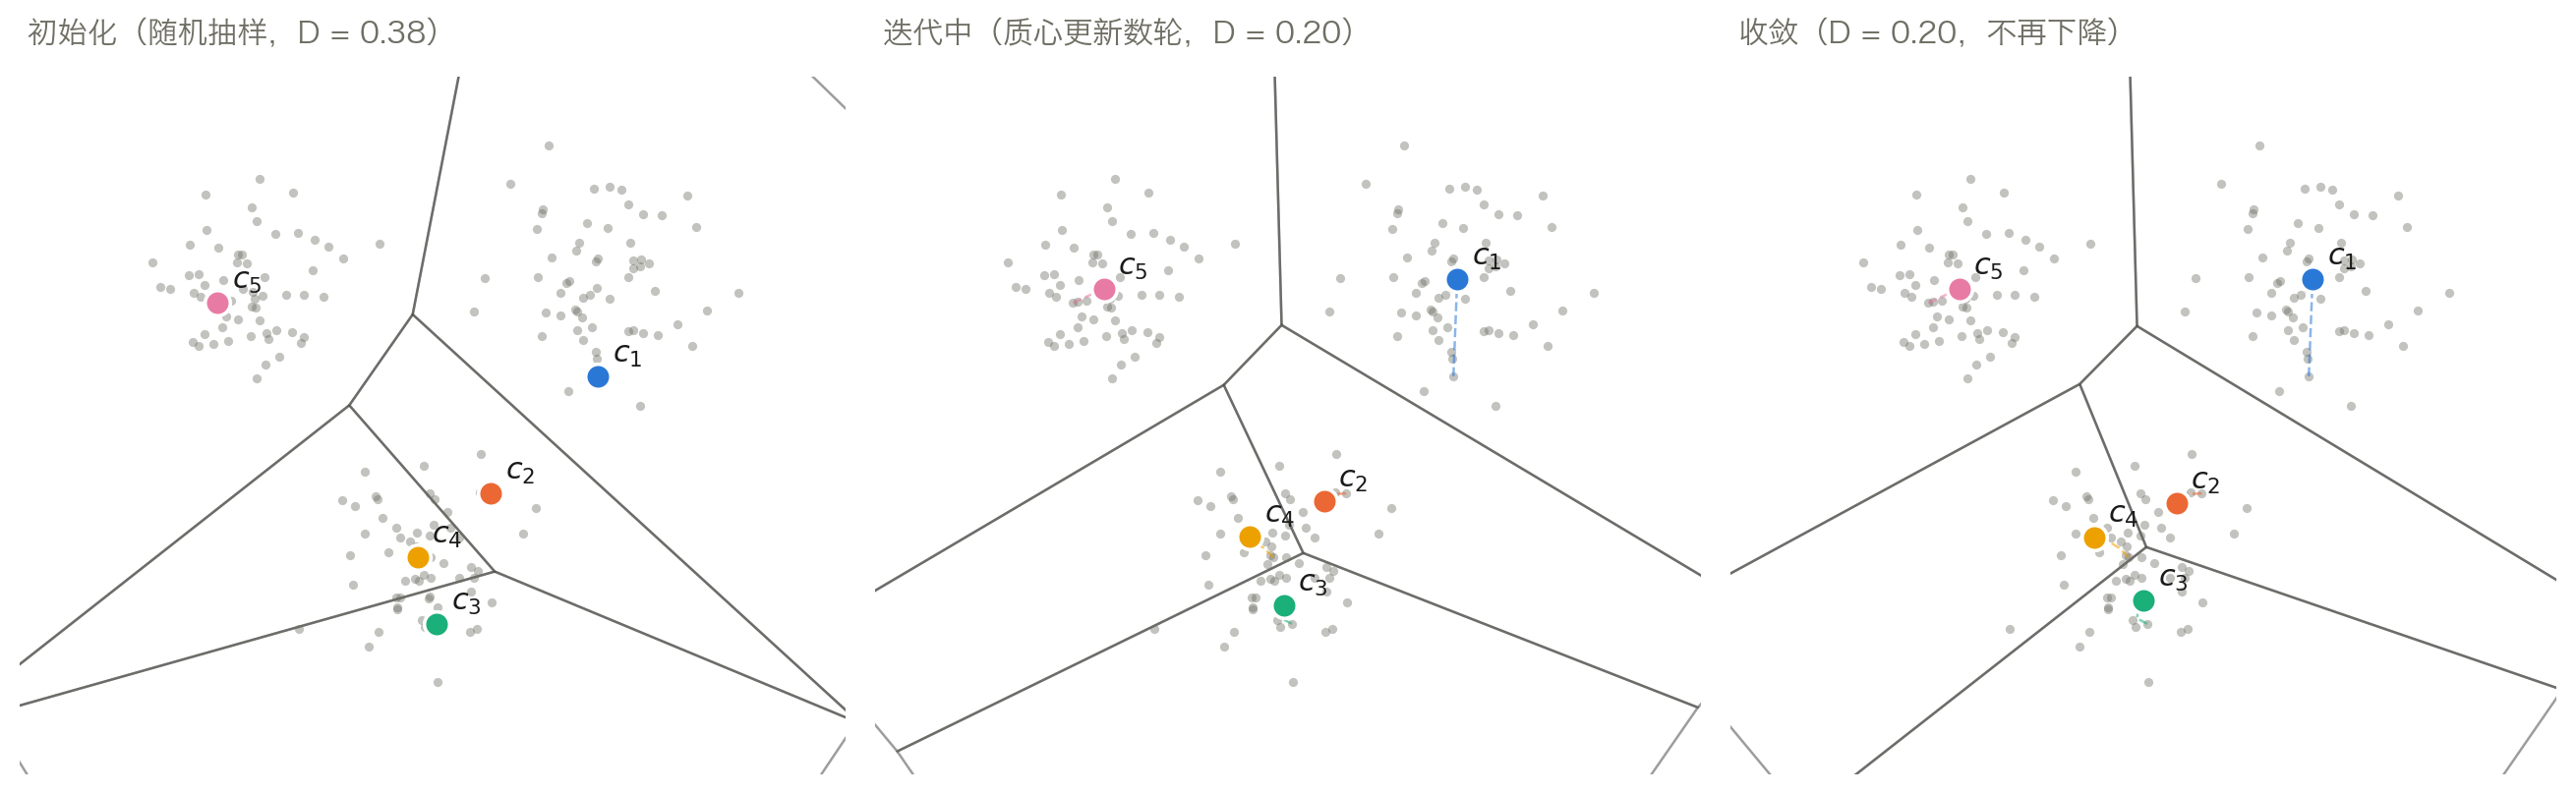
三帧对照:随机初始的码矢沿虚线轨迹逐轮走到所在胞腔的质心,失真单调下降后停滞。 而数据只有 3 簇——收敛后两个码矢挤进同一簇,正是局部最优的直观形态。
理论极限与维度诅咒
率失真理论给出压缩的下界。 维无记忆高斯信源在 MSE 下的率失真函数:
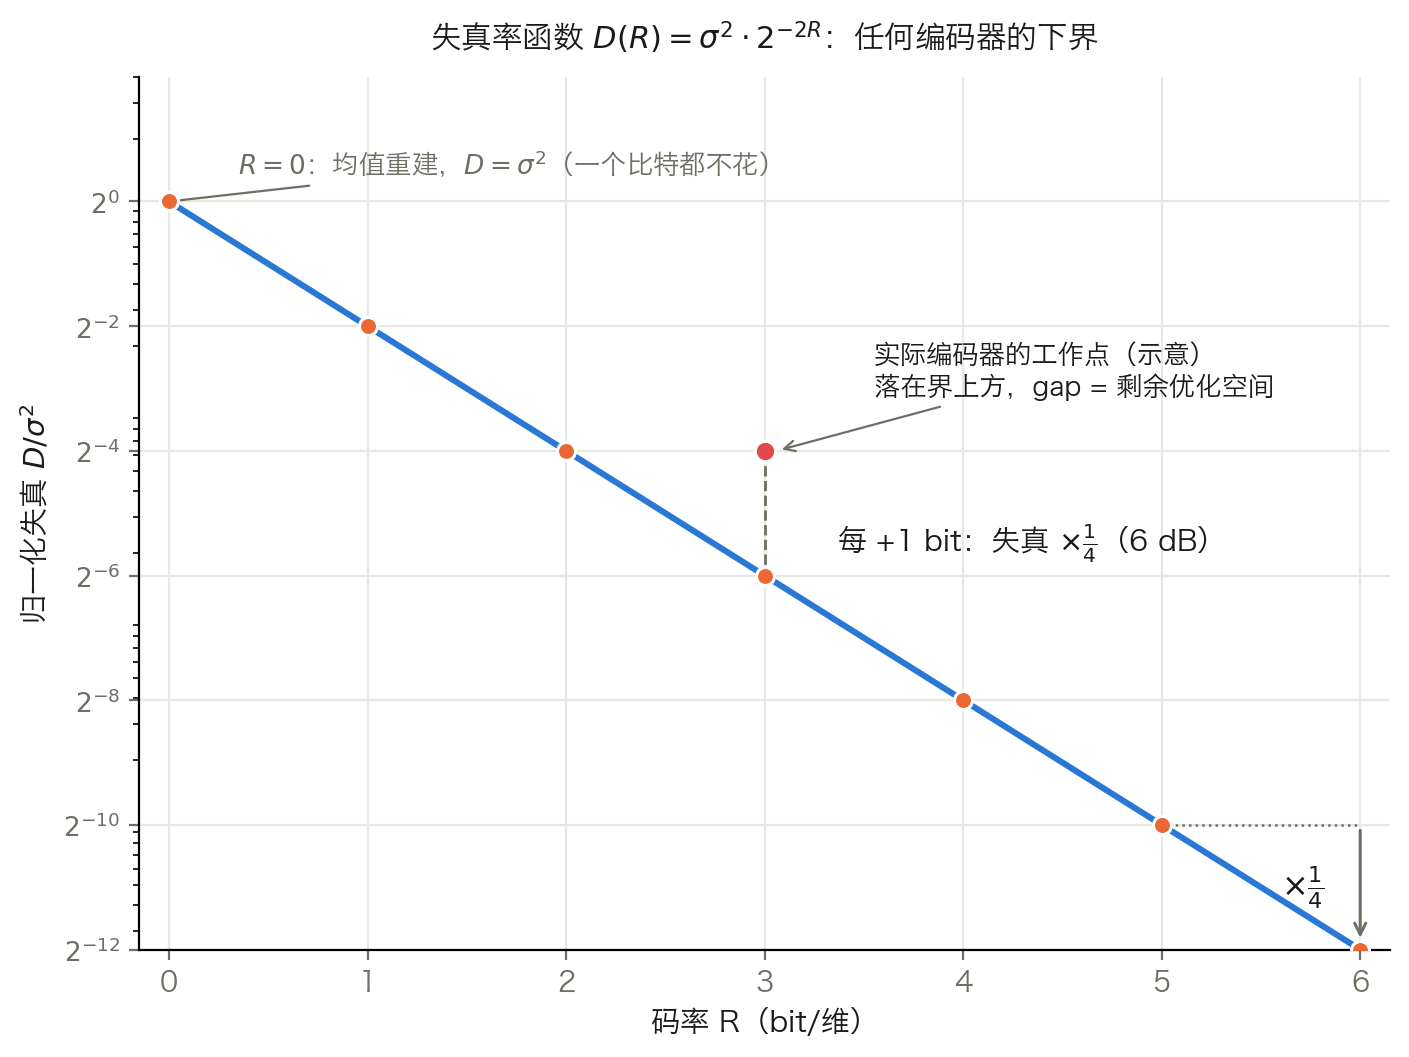
反解出失真-码率函数 ,它在 log 轴下是直线:每 +1 bit 失真 ×¼。任何编码器的 工作点都只能落在界上方,到界的距离就是剩余的优化空间。
VQ 的核心理论结论是矢量量化增益:维度 越大,性能可任意接近这个界——标量量化永远到不了。直觉来自相关性:标量量化逐个处理数值,完全忽略数据间的相关——图像相邻像素高度相关,独立量化每个像素等于反复为冗余付费;2×2 的四个像素拼成 4 维矢量一次量化,相关性被码本整体「打包吸收」。这是「整体大于部分之和」在信息论里的具体形态。
代价是维度诅咒。比特率固定时码本大小 随维度指数爆炸: 、 bpd 时 ; 时 65536; 时 ——存储与最近邻搜索(每次量化 次距离计算)都不可行。KD 树、球树在高维下退化到接近暴力扫描。传统 VQ 因此只服务低维场景(语音参数 10–20 维),高维特征必须走结构化分解,这就是 乘积量化(PQ):高维向量检索的工程基石 的出发点。
应用版图:哪里真用了 VQ
语音编码是 VQ 的起家之地:CELP 系标准(G.729 以 8 kbps 压到接近长途音质、AMR 全系)里,LSP 参数和激励信号都靠矢量量化——激励码本搜索本质就是最近邻查表。
常见误读是以为图像视频标准也用了 VQ——其实没有:JPEG(DCT + 均匀标量量化)、JPEG2000(小波 + 标量死区量化 + EBCOT 熵编码)、WebP、AV1 全部是「变换 + 标量量化 + 熵编码」三段式。VQ 图像编码是 1980–90 年代的研究线,未进入主流标准。
深度学习时代 VQ 换了主战场,三条线各自成篇:检索用乘积量化压库向量(见 PQ 篇);生成模型用 VQ 造离散潜空间(VQ-VAE 一族,见 VQ-VAE);权重量化的谱系值得澄清——Han 等人 2015 年的 Deep Compression 用 k-means 聚类做权重共享,是真正的 VQ;而 GPTQ、AWQ 严格说是 4-bit 标量 PTQ 的精化(Hessian 误差补偿、激活感知缩放),常被泛称为「矢量量化思想」,属宽泛借用;NF4、FP8 则是数值格式,与 VQ 无关。
术语速查
| 术语 | 英文 | 一句话释义 |
|---|---|---|
| 最近邻条件 | nearest-neighbor condition | 固定码本时,最优划分是按最近码矢归类的 Voronoi 划分 |
| 质心条件 | centroid condition | 固定划分时,最优码矢是所在胞腔的质心 |
| 坐标下降 | coordinate descent | 交替固定一半变量优化另一半;LBG 的收敛机制 |
| 空胞腔 | empty cell | 长期无样本归属的胞腔,对应码矢退化为死码 |
| 分裂法 | splitting | 从 1 个码矢起步反复分裂到 ,最稳的 LBG 初始化 |
| 矢量量化增益 | VQ coding gain | 维度 增大时性能可逼近率失真界,标量量化做不到 |
| 维度诅咒 | curse of dimensionality | 随维度指数爆炸,存储与搜索都不可行 |
| LSP | line spectral pairs | 线谱对参数,语音编码中 VQ 量化的主要对象 |
| CELP | code-excited linear prediction | 码激励线性预测,VQ 起家的语音编码标准族 |
| PTQ | post-training quantization | 训练后量化;GPTQ/AWQ 属其 4-bit 标量精化,非 VQ |
深入阅读:Gersho & Gray《Vector Quantization and Signal Compression》(1992,领域圣经);LBG 原始论文(1980)。