绝对位置编码给每个位置分配一个唯一向量并加到词嵌入上,用最小的改动让自注意力感知顺序;它的两种形态——正弦公式与可学习参数——分别在外推能力和拟合能力上做了相反的取舍。
定义与注入方式
绝对位置编码(Absolute Positional Encoding, APE)为每个位置索引 分配一个与词嵌入同维的向量 ,在进入第一层 Transformer 前直接相加:
关键在于加法而非拼接。拼接会挤占词嵌入的表示空间并增加后续所有权重矩阵的宽度;加法则让位置信息与语义信息共享同一 维空间,靠残差流在各层间自然传播。代价是位置与语义在同一子空间里纠缠,模型必须自己学会解耦——这是 APE 与后来 旋转位置编码(RoPE) 那种「作用在 Q/K 上而非嵌入上」的路线的根本分歧。
注入只发生一次。深层 Transformer 依赖残差连接把位置信号带到高层,因此层数越深、信号衰减越明显,这也是 位置编码 谱系后来倾向于「每层注入」的动因。
正弦位置编码
原始 Transformer 用一组不同频率的三角函数直接算出 ,无需训练:
记角频率 ,则第 对维度构成一个以 旋转的二维「时钟」,整个向量是 个不同转速时钟的读数拼接。
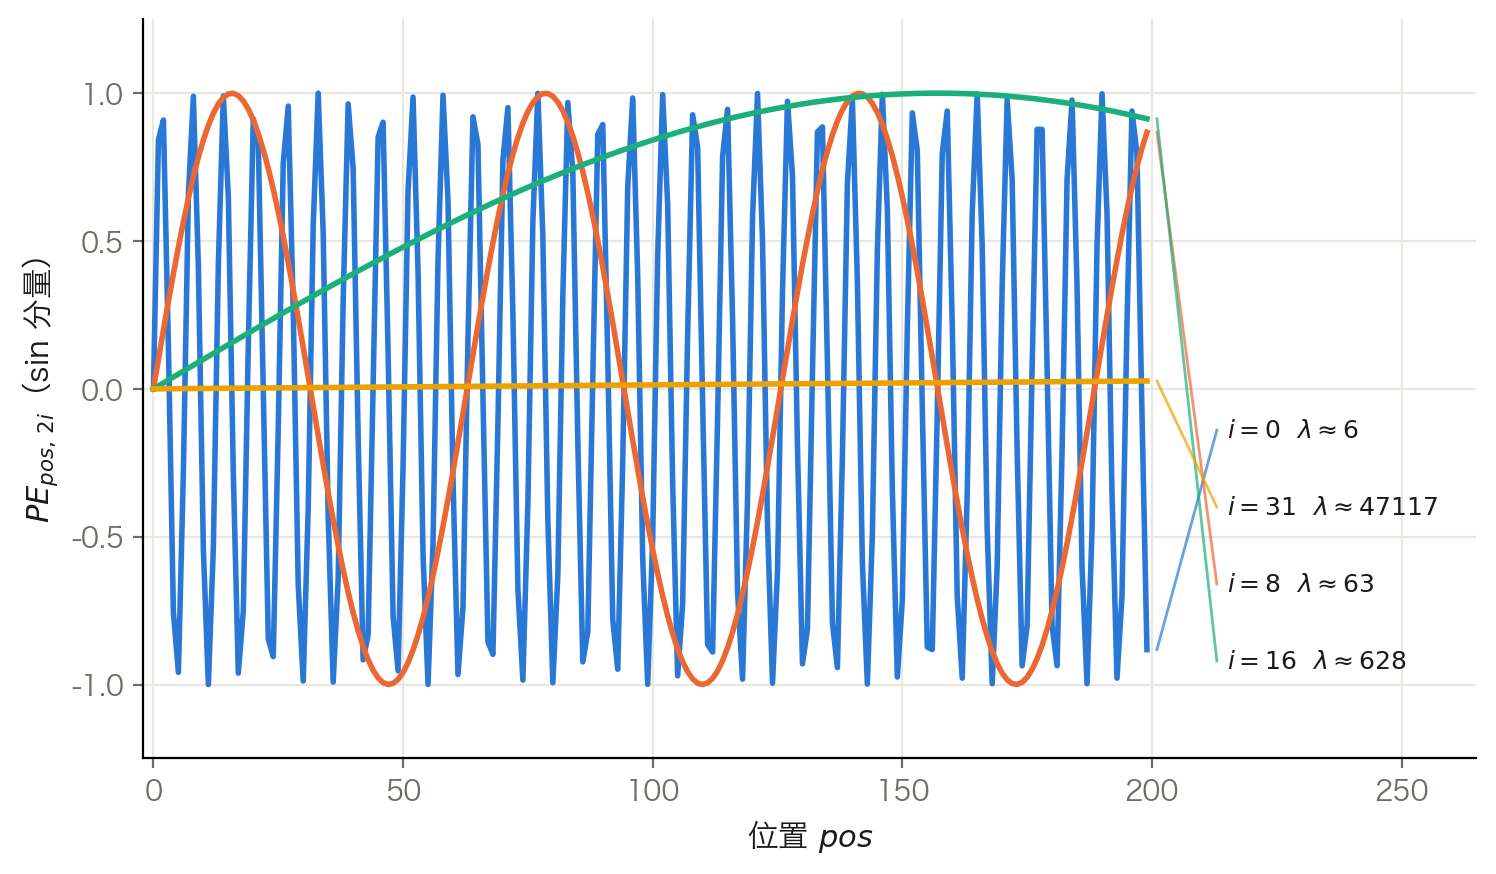
四个代表「时钟」的读数轨迹: 在十几个 token 内振荡数个周期, 在 200 长度内近似线性——两者的转速差超过四个数量级。
唯一性
单个频率有周期性, 会重复。但 个频率呈几何级数分布,波长从 一直拉到 ,所有时钟同时回到同一读数组合需要的周期远超任何实际序列长度。这与混合基数计数系统同理:低位快速翻转,高位缓慢推进,组合起来给出无歧义的编码。
相对位置的线性表达
这是选用三角函数而非随机固定向量的核心理由:位置偏移 对应一个与 无关的线性变换。由和差角公式,对第 对维度有
写成矩阵形式:
即 ,其中 是由 个二维旋转块组成的分块对角正交矩阵,只依赖 。于是注意力层的线性投影有可能学到某个逼近 的变换,从而间接感知相对距离。
两点必须说清。其一,这只是「可线性表达」,不是「已经编码进注意力分数」——真正把相对距离写进 的是 RoPE,它把同样的旋转矩阵作用在 Q/K 上而非嵌入上。其二,内积 只依赖 ,是 的偶函数,无法区分前后方向;方向性只能靠语义嵌入与后续权重补偿。
多尺度
频率几何级数分布带来天然的分工:高频维度(小 )波长短,相邻位置读数差异显著,负责局部语序;低频维度(大 )在数百个 token 范围内近似线性变化,负责全局篇章位置。这一「多分辨率」思想被后续方案继承——RoPE 长度外推与插值 里的 NTK-aware 缩放正是对不同频段做差异化处理,而非全局等比拉伸。
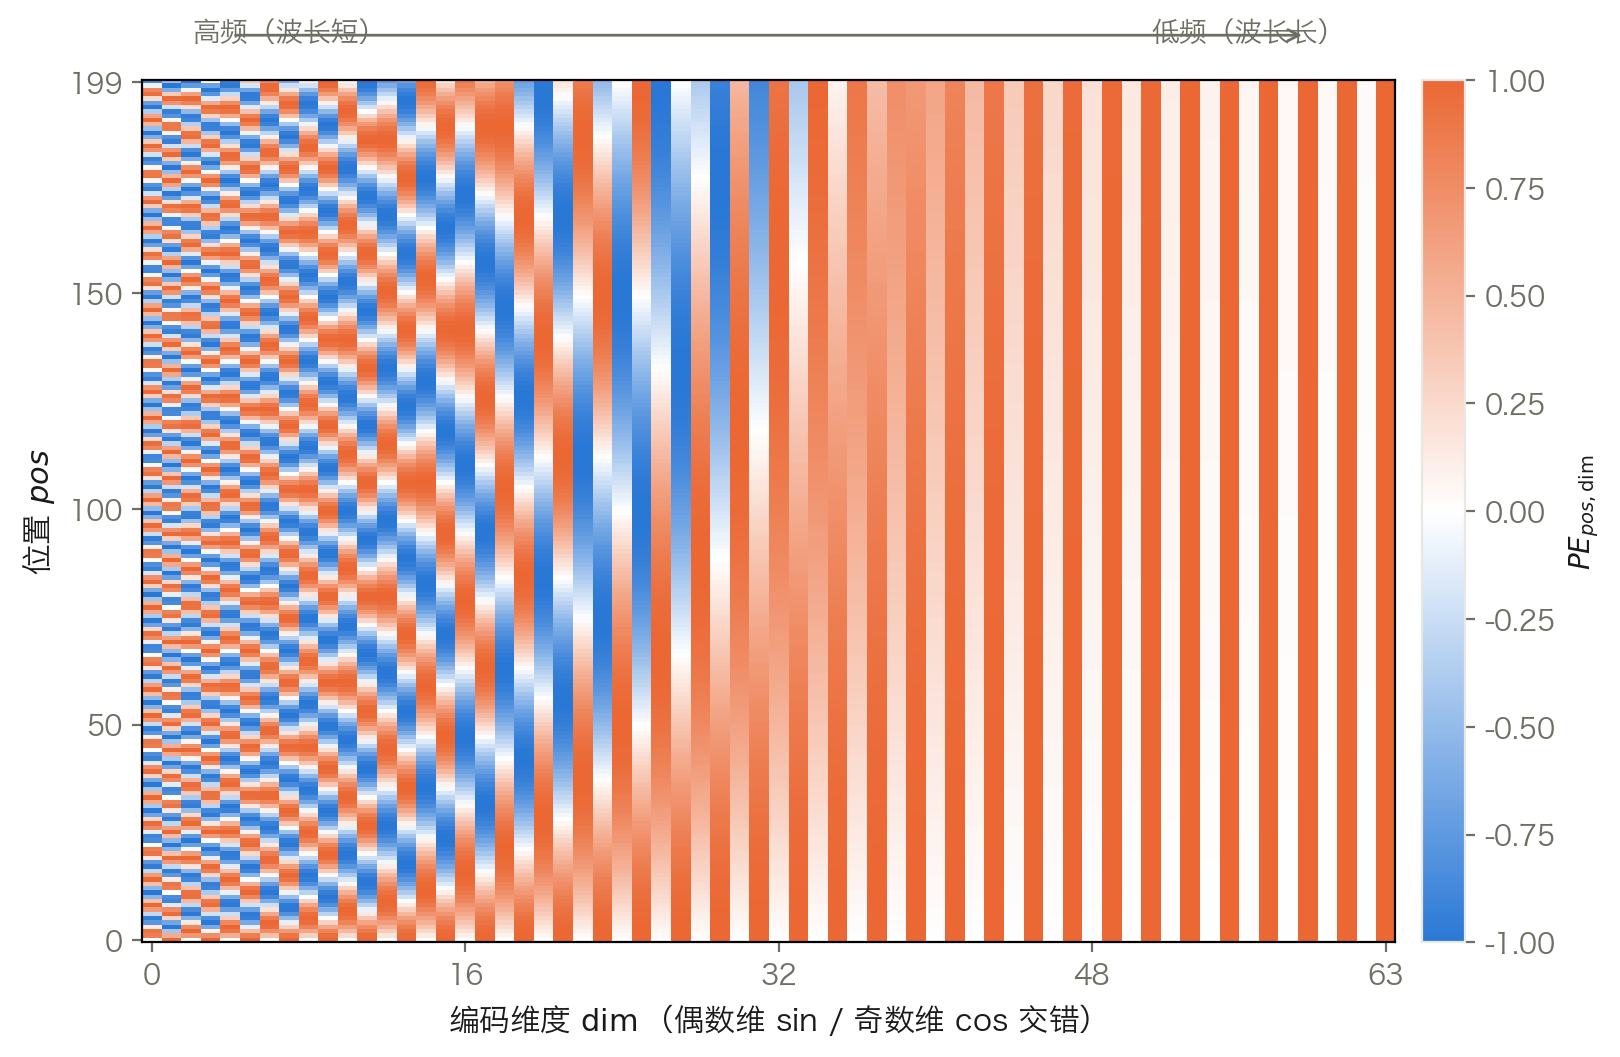
整个 矩阵的一瞥:每行即一个位置的编码向量,左半密集条纹(高频)随位置快速翻转,右半缓变色带(低频)在数百 token 内近乎线性推进。
可学习位置编码
BERT、GPT-2、ViT 的做法:把 直接声明成形状 的可训练参数矩阵,随机初始化后与模型联合优化。
import torch
import torch.nn as nn


class LearnedPositionalEmbedding(nn.Module):
    def __init__(self, max_len: int, d_model: int):
        super().__init__()
        self.pos_emb = nn.Embedding(max_len, d_model)

    def forward(self, x):  # x: (batch, seq_len, d_model)
        positions = torch.arange(x.size(1), device=x.device)
        return x + self.pos_emb(positions)  # 广播到 batch 维
在训练长度内,可学习编码通常略优于正弦编码——它能拟合语料特有的位置分布(如句首偏置、固定模板位置),不受三角函数形式约束。但代价是三条硬限制:
- max_len 是硬墙。超出预设长度没有任何参数可查,模型直接崩溃。正弦编码至少能算出数值(尽管效果也差)。
- 参数量随上下文线性增长。,128K 上下文、 就是 5 亿参数只用来记位置。
- 尾部位置训练不足。语料中长样本稀少,靠后位置的 embedding 更新次数远少于靠前位置,质量参差。
| 维度 | 正弦编码 | 可学习编码 |
|---|---|---|
| 参数量 | 0 | |
| 训练长度内效果 | 基线 | 略优 |
| 超长度行为 | 可计算但效果退化 | 无定义,直接失效 |
| 相对位置 | 可线性表达(隐式) | 无结构保证 |
| 典型模型 | Transformer 原版 | BERT / GPT-2 / ViT |
正弦编码的 PyTorch 实现
用 register_buffer 存放预计算表:它随模型 .to(device) 迁移、被 state_dict 保存,但不进入 parameters(),因此不参与梯度更新。这是「有状态但不可训练」张量的标准写法。
import math
import torch
import torch.nn as nn


class PositionalEncoding(nn.Module):
    def __init__(self, d_model: int, max_len: int = 5000, dropout: float = 0.1):
        super().__init__()
        self.dropout = nn.Dropout(dropout)

        pe = torch.zeros(max_len, d_model)
        position = torch.arange(max_len, dtype=torch.float).unsqueeze(1)  # (max_len, 1)
        # 在对数域计算 1/10000^(2i/d),避免大指数下溢
        div_term = torch.exp(
            torch.arange(0, d_model, 2, dtype=torch.float) * (-math.log(10000.0) / d_model)
        )  # (d_model/2,)

        pe[:, 0::2] = torch.sin(position * div_term)  # 偶数维用 sin
        pe[:, 1::2] = torch.cos(position * div_term)  # 奇数维用 cos

        self.register_buffer("pe", pe.unsqueeze(0))  # (1, max_len, d_model)

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        """x: (batch, seq_len, d_model)"""
        x = x + self.pe[:, : x.size(1)]
        return self.dropout(x)


if __name__ == "__main__":
    pe = PositionalEncoding(d_model=512)
    out = pe(torch.zeros(2, 100, 512))
print(out.shape) # torch.Size([2, 100, 512])两处易错点:div_term 必须在对数域算,直接写 1 / 10000 ** (2 * i / d) 在 float32 下会下溢为 0;pe 的 batch 维用 unsqueeze(0) 预留,否则每次 forward 都要重新广播。
局限与后续路线
APE 的三个结构性缺陷共同推动了整个位置编码谱系的演进:
长度外推弱。正弦编码在超出训练长度时数值仍可计算,但注意力模式已落到训练时未见过的分布上,困惑度急剧上升;可学习编码更是直接无参数可用。ALiBi 用固定的线性距离惩罚替换加法编码,把外推变成设计目标而非侥幸。
无显式相对位置建模。绝对位置只保证「可线性表达」相对关系,而语言的语法依赖本质上是相对的——“the cat sat” 中 cat 与 sat 的关系不该因整句在文档中的偏移而改变。相对位置编码 把距离项直接写进注意力分数,RoPE 则通过旋转让 天然只依赖 。
参数与上下文长度耦合。可学习编码的参数量线性膨胀,与当代模型动辄百万 token 上下文的目标根本冲突。零参数的相对/旋转方案是唯一可扩展路径。
理解 APE 的意义不在于沿用它——现代主流架构已基本弃用——而在于它把「位置该如何进入注意力」这个问题的解空间划清了边界:注入位置(嵌入层 vs 注意力分数)、编码形式(固定 vs 可学习)、参照系(绝对 vs 相对),后续所有方案都是在这三个轴上重新选点。