寻址公式 是 stride 的全部语义:多维索引如何落进一维 Storage。切片、转置、广播之所以零拷贝,正因为它们只改公式里的参数,不搬数据。
从索引到偏移
import torch

t = torch.arange(12).reshape(3, 4)
t.stride()   # (4, 1):沿第 0 维走一步跨 4 个元素,第 1 维跨 1 个
t[1, 2]      # tensor(6)
t[1,2] 读的不是「第 1 行第 2 列」这个抽象位置,而是 Storage 中第 个元素——寻址公式可以手动执行:
t.flatten()[6]                            # tensor(6)
torch.as_strided(t, (3, 4), (4, 1))[1, 2] # 同一块内存,显式写出 stride
stride 的单位是元素而非字节;字节偏移要再乘 t.element_size(),data_ptr() 返回的才是字节数。
零拷贝视图:只改公式参数
一切视图操作的共性:Storage 不动,只改 三元组:
| 操作 | shape | stride | offset |
|---|---|---|---|
t | (3, 4) | (4, 1) | 0 |
t.t() | (4, 3) | (1, 4) | 0 |
t[1:] | (2, 4) | (4, 1) | 4 |
t[:, ::2] | (3, 2) | (4, 2) | 0 |
t.unsqueeze(0) | (1, 3, 4) | (12, 4, 1) | 0 |
t.unsqueeze(0).expand(2, 3, 4) | (2, 3, 4) | (0, 4, 1) | 0 |
转置交换 stride,切片平移 offset,步长切片放大 stride,expand 干脆把 stride 置 0——广播的「虚拟复制」由此而来(见 Tensor 广播机制)。
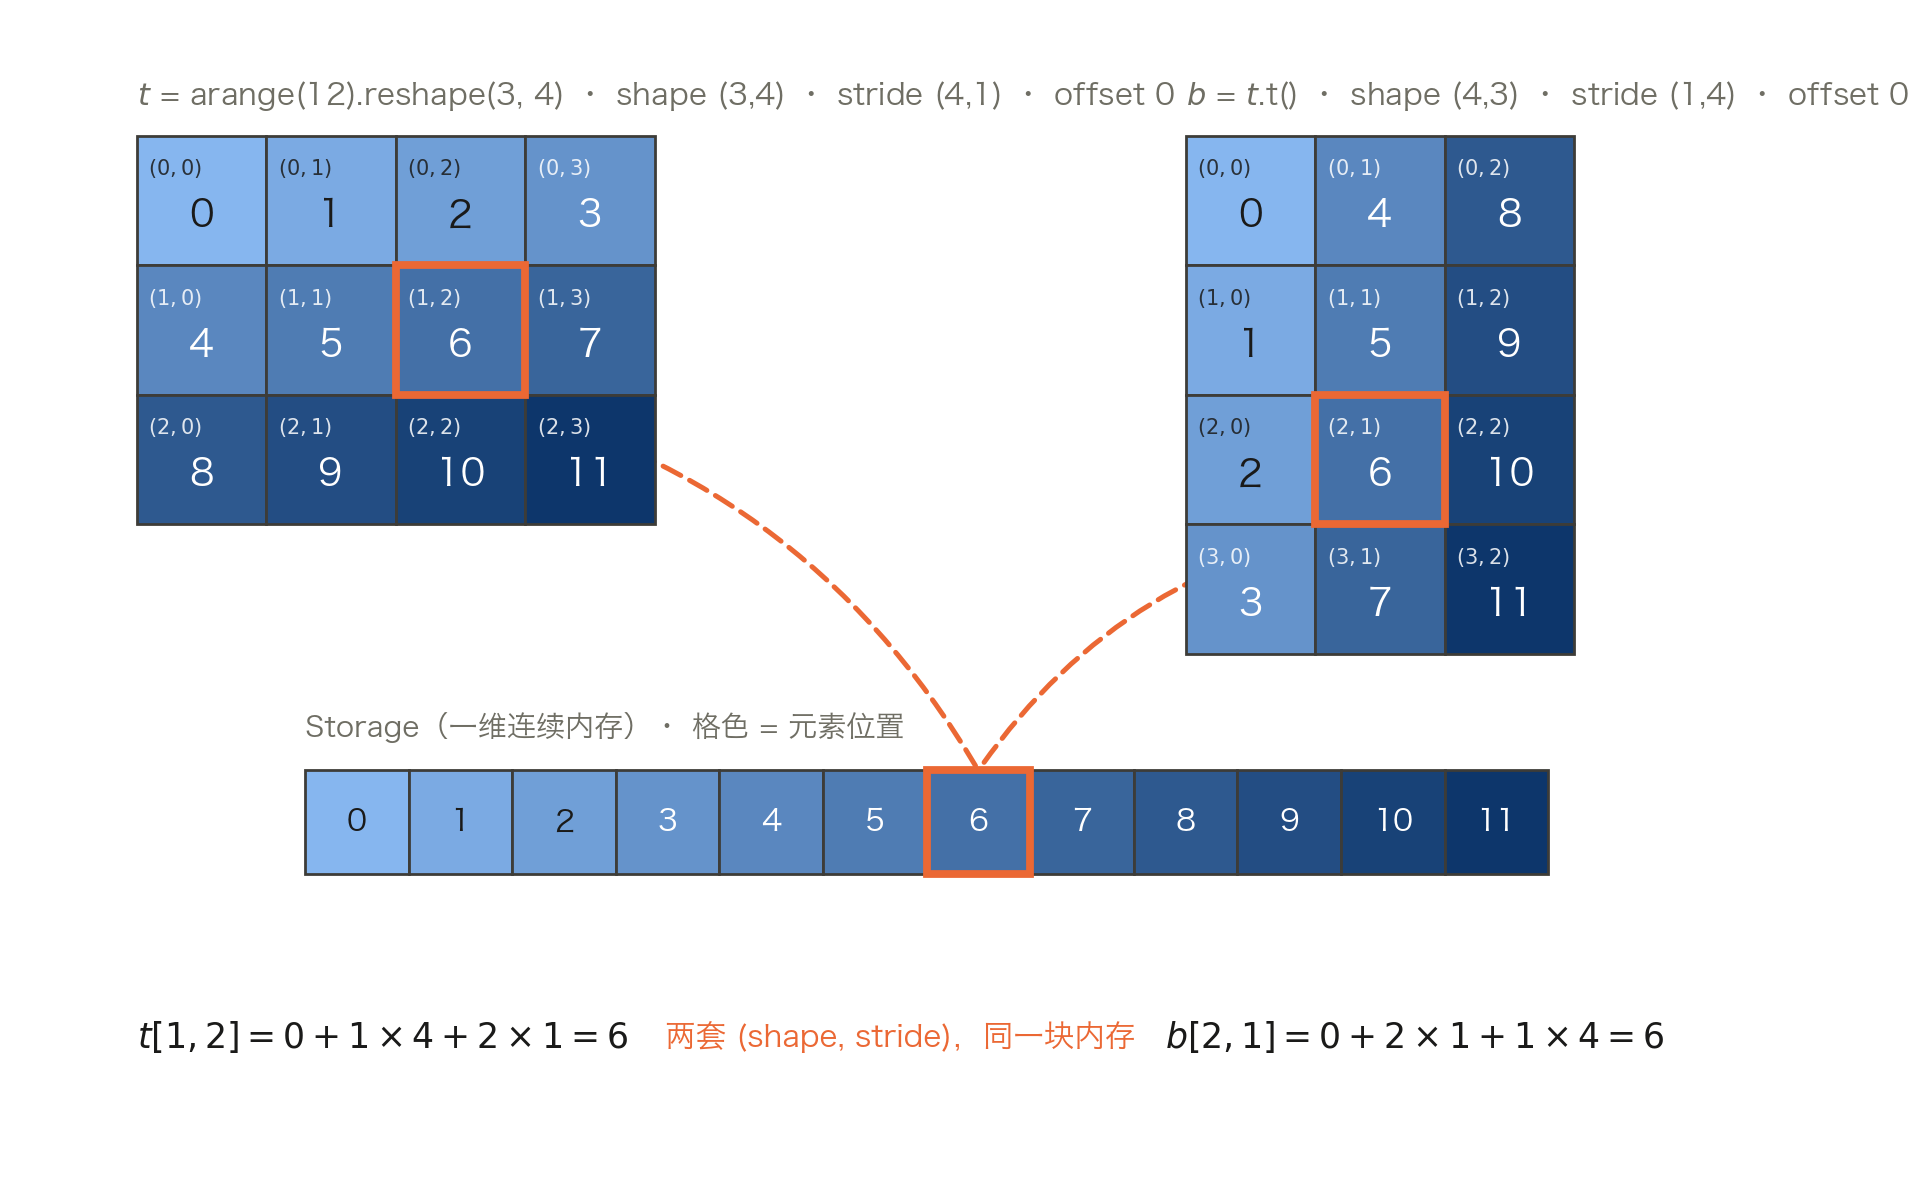 格色即存储位置:两个视图的色块集合完全相同、只是排布不同——同一块内存的两套读法;橙色示例 与 殊途同归,都指向第 6 格。
contiguous:stride 的默认约定
行优先(C contiguous)时 stride 是各维长度的后缀连乘:,故 (3, 4) 配 (4, 1)。is_contiguous() 判定的正是:从 offset 起、按行优先顺序递增索引,寻址公式恰好无间隔、无重叠地扫过 Storage。
t.t().is_contiguous()为False:stride (1, 4) 按行扫出的偏移序列是 0, 4, 8, 1, 5, 9…,有跳跃view要求 stride 兼容,reshape在不能共享时静默复制——大张量上这是显存翻倍的隐性来源- 非连续张量喂给部分 CUDA kernel 前会被隐式
contiguous(),读代码估算显存时要计入
as_strided:直接书写三元组
v = torch.as_strided(t, (2, 3), (4, 2), storage_offset=1)
# 读出 storage[1,3,5 / 5,7,9]:两行互相重叠的滑动窗口unfold、卷积滑窗的底层实现正是它。但 as_strided 不检查越界——错误的 stride 会读到相邻内存的垃圾值甚至直接崩溃,用它时务必手动核对寻址公式。
元数据四要素与 Storage 的整体图景见 Tensor 与 Storage;stride=0 的广播语义见 Tensor 广播机制。