计算图不是一张显式存在的数据结构:前向传播每做一次运算,就顺手记一条「这次怎么反着算」,记录串成链即为图;反向走完整条链便释放,梯度最终只落在叶子节点上。
autograd 的分工:你只写前向代码,backward() 自动算出每个参数的梯度。支撑它的是链式法则加一份运行时记录——链式法则把「输出对输入的整体导数」拆成一串局部导数的乘积,每个局部导数只取决于这一步做了什么运算,乘法、加法、sum 各有固定的反向公式。每个运算发生的瞬间留下一条记录,任意深的网络都能自动求导;这些记录串成的链,就是下文的计算图。
计算图:grad_fn 串成的链
要让框架替你求梯度,先声明对谁求:创建张量时传 requires_grad=True,意思是「请跟踪与它有关的一切运算」。这是 autograd 的开关——模型参数(nn.Parameter)默认开启,输入数据按需开启;不开,后续机制都不启动。
声明之后,y = x * w 执行的瞬间,PyTorch 创建一个 MulBackward0 节点——名字直译是「乘法的反向」——记住这次乘法的反向公式,挂进结果张量的 grad_fn 字段。所谓计算图,物理上就是这些 grad_fn 引用串成的链:每个节点用 next_functions 指向产生自己各个输入的节点。从 loss 沿 next_functions 逐层回走,走出的正是稍后 backward() 要走的路径:
import torch

x = torch.randn(3, requires_grad=True)
w = torch.randn(3, requires_grad=True)
b = torch.randn(3)
y = x * w
u = y + b
z = u.sum()

node = z.grad_fn                    # SumBackward0
node = node.next_functions[0][0]    # AddBackward0
node = node.next_functions[0][0]    # MulBackward0(b 未跟踪,链上没有它的节点)
node.next_functions # ((AccumulateGrad(x),), (AccumulateGrad(w),))手动走一遍:SumBackward0 → AddBackward0 → MulBackward0,与代码里的 sum、加法、乘法一一对应,方向相反。b 未声明 requires_grad,链上没有它的节点——数值照常参与前向,梯度体系绕开它。链尾的 AccumulateGrad 是不做运算的隐形节点,职责只有一件:把回流的梯度累加进对应叶子的 .grad。累加而非覆盖,训练循环每步的 optimizer.zero_grad() 由此而来——不清零,本轮梯度会和上一轮残余叠在一起。
把图直接画出来
torchviz.make_dot(z)能把整条链渲染成图,排查「梯度为什么断了」时比肉眼读代码快——断链位置一目了然。
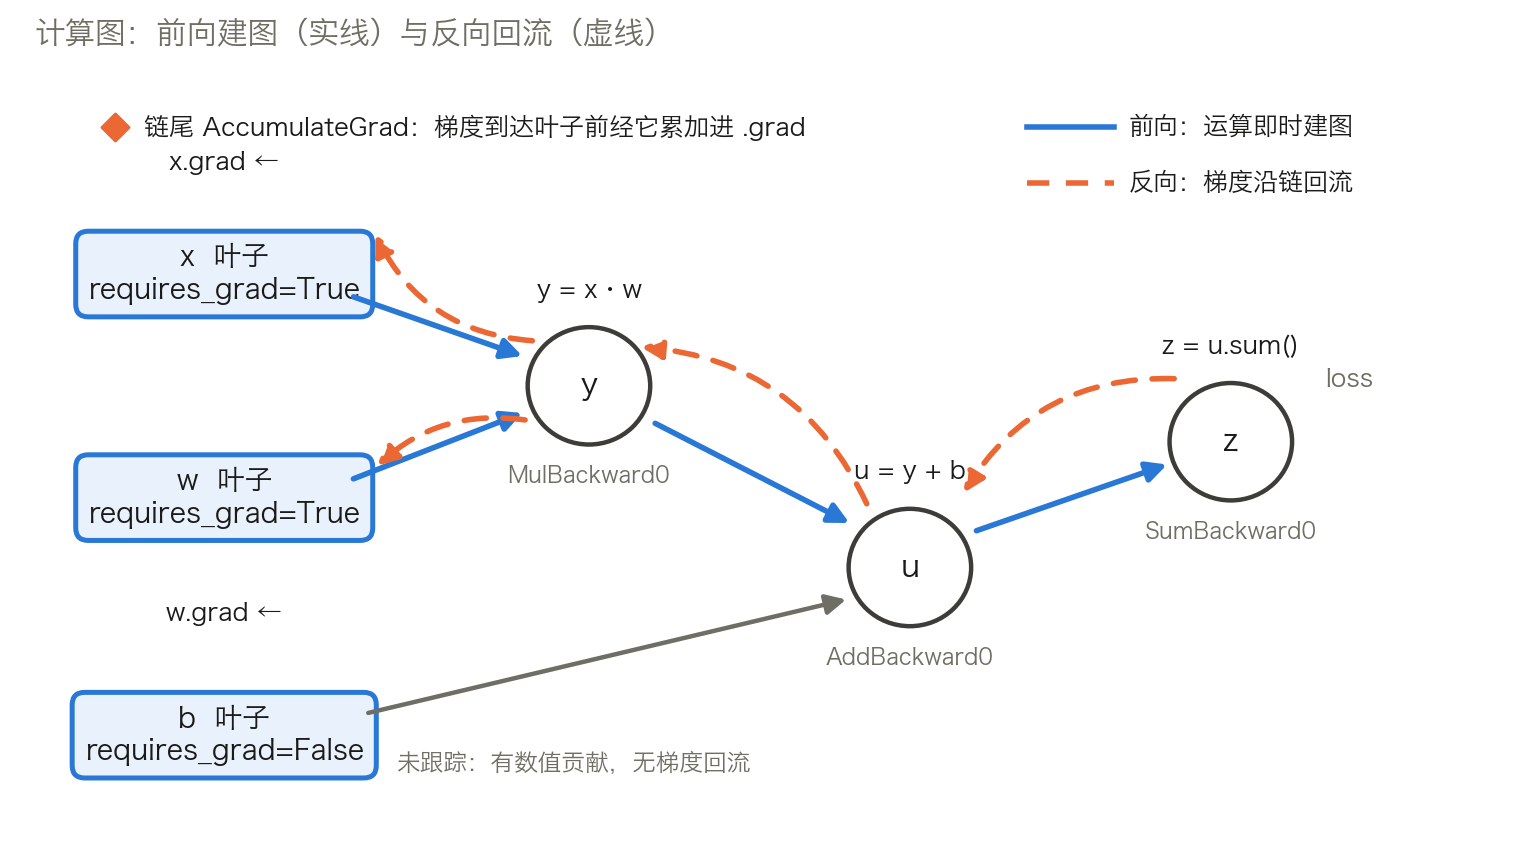 实线为前向:每个可导运算即时挂出自己的反向节点;虚线为 backward 的回流路径。注意
b 未开启 requires_grad——数值照常参与运算,梯度链却绕开它。
叶子节点:is_leaf 的判定
叶子(leaf node)即计算图的起点:不由本轮图里的运算产生、而是用户直接创建的张量——torch.randn() 造出的输入、nn.Parameter 造出的参数都是叶子,中间结果不是。单独给它命名,因为训练以轮为单位循环:中间结果每轮前向重建,梯度存上去必然随图丢失;参数与输入才跨轮存活、需要累积梯度。backward 因此只写叶子的 .grad,中间结果的 .grad 恒为 None,确需查看时对该张量调 retain_grad()。
判定规则一张表说尽:
| 张量 | is_leaf |
|---|---|
用户直接创建(无论 requires_grad) | True |
| grad 模式下运算的产物 | False |
no_grad 下运算的产物 | True |
detach() 的产物 | True |
前两行是定义的正反面:直接创建即起点,grad 模式下运算的产物带历史、不是起点。后两行:torch.no_grad() 里运算根本不建图,产物没有历史,天然是起点;detach() 把张量从图上剪下来,数值与原张量共享存储,但不再认自己的计算历史,也是起点。
x = torch.randn(3, requires_grad=True)
y = x * 2                       # 记录了求导历史 → 非叶
with torch.no_grad():
    z1 = x * 2                  # 图根本没建 → 叶
z2 = y.detach()                 # 从图上剪下来 → 叶
y.is_leaf, z1.is_leaf, z2.is_leaf   # False True True
requires_grad=False 的叶子永远没有 .grad,哪怕数值深度参与前向——前文图里的 b 就是这个角色:参与运算,不被跟踪。
叶子与 in-place
已参与建图的 requires_grad 叶子做 in-place 运算,直接报
a leaf Variable that requires grad is being used in an in-place operation。叶子没有grad_fn、没有历史,原地改写无处记录,梯度会静默出错,框架干脆拒绝。参数更新这类必须原地改写的操作由 optimizer 在no_grad下完成(见 torch.optim)。
前向建图,反向释放
动态图的完整生命周期是四拍:前向逐运算建图 → backward 沿链回流并释放中间缓冲 → 图已消费,再反传报错 → 下一轮前向长出全新的图。
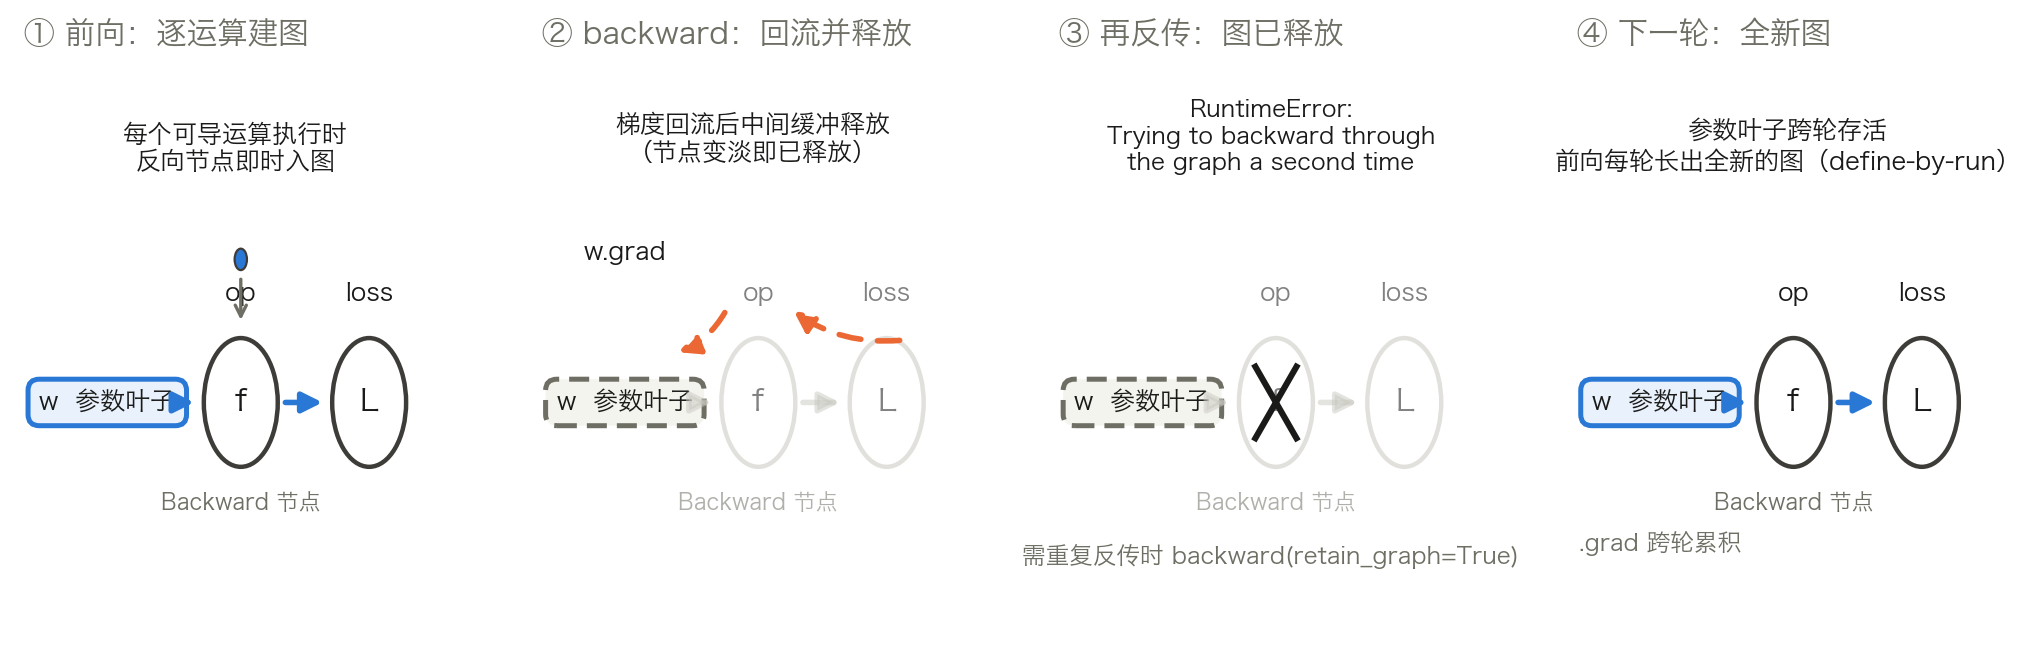 四拍中变淡的节点即已释放的图:③ 里没有图可走,只有报错;④ 里参数叶子带着累积的
.grad 存活,新图与前一轮无关。
这就是 define-by-run:图是执行的副产品,if、循环、动态 shape 天然融进图里,无需额外 DSL 描述。静态图框架(如早期 TensorFlow)要先把网络声明成固定的图再喂数据执行——这是动态图后来居上的核心体验差异(见 深度学习框架对比)。
代价在第三拍:反向默认释放图,第二次 backward() 报:
RuntimeError: Trying to backward through the graph a second time
(or through the graph saved state before a previous forward).
持有中间张量的 Python 引用救不回第二次反传——「释放」的语义是图已被消费,不只是内存回收;确需重复反传(RL 的二次梯度、GAN 多判别器共享生成器)用 backward(retain_graph=True),拿显存换灵活性。
沿链再走远一步:反向传播本身的 VJP 数学、no_grad 与 inference_mode 的取舍,见 torch.autograd;grad_fn、requires_grad 与 shape/stride 一样都是 Tensor 头上的元数据,见 Tensor 与 Storage。